
QiangDiao Li
准备向 Busabase 导入一批资料,不可能逐条人工检查,但只看前十条也可能漏掉问题。除了核对总数量,应该怎样挑选包含长文本、特殊字符、多条关联或缺失信息的样本?希望检查方法能覆盖不同情况,而不只是确认最简单的几条正常。
准备向 Busabase 导入一批资料,不可能逐条人工检查,但只看前十条也可能漏掉问题。除了核对总数量,应该怎样挑选包含长文本、特殊字符、多条关联或缺失信息的样本?希望检查方法能覆盖不同情况,而不只是确认最简单的几条正常。

核对大批导入时,总行数必要但不充分;只看前十条也容易只覆盖「最乖」的数据。更稳的做法是:先做总量与约束检查,再按风险类型 分层抽样,每类打开几条对照源文件。
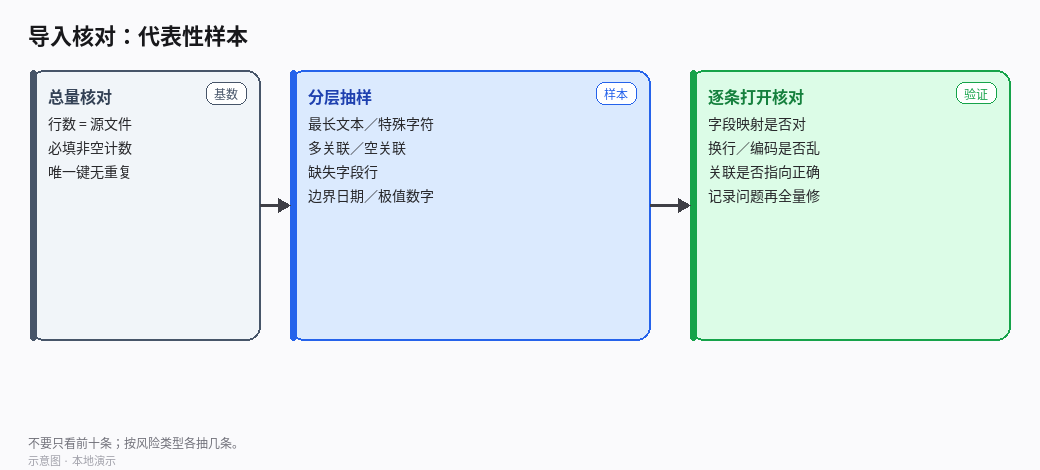
*示意图 · 总量核对 → 分层抽样 → 逐条打开*
| 样本类型 | 为什么抽 |
|---|---|
| 最长文本 | 截断、换行、富文本丢失 |
| 特殊字符 | 逗号/引号/Emoji/多语言/全角符号 |
| 多条关联 | 关联是否拆对、是否指到错误记录 |
| 空/缺失 | 空值是否被写成 0、默认值或「空字符串」 |
| 边界日期与极值数字 | 时区、格式、科学计数法、过大过小 |
| 源文件末尾与中间段 | 避免只抽文件头 |
对抽中的样本:对照源字段 → Busabase 字段映射、显示是否乱码、关联目标是否正确。发现问题先修正映射/清洗规则,再决定是否整批重导。
如果你愿意提供字段列表(哪些是关联/长文本/必填),可以帮你缩一版「最少要抽哪些类」的检查表。
Sign in to join the discussion. Reading is always open; you only need an account to post.
Sign in